AI a zdraví: jak si nechat bezpečně radit
AI používám na zdraví pravidelně: dávám jí výsledky krve, záznamy spánku a tréninku a ptám se na souvislosti. Slovo „bezpečně“ v nadpisu má dva významy. Za prvé rady, kterým můžu věřit: čísla z mých dat, ověřitelná, bez halucinací. Za druhé soukromí: vím, kde moje data skončí a kdo je uvidí. Obojí spojuje jedna věta: čím víc dat dáš AI, tím lepší odpovědi, ale tím víc riskuješ. Článek je o obojím: nejdřív o ověřených radách, pak o soukromí. Všechna čísla v příkladech jsou vymyšlená.
AI umí vymyslet číslo a znít jistě
Představ si odpověď: „Vaše hladina pohody v krvi je 87,3 mmol/l.“ Zní to přesně, má to i jednotku. Jenže „hladina pohody v krvi“ neexistuje. Číslo i jednotka jsou vymyšlené.
Chatboti jako ChatGPT, Gemini, Claude nebo Grok jsou postavení na velkých jazykových modelech (LLM). Takový model se učí předpovídat další slovo v textu. Když mu chybí data, doplní něco, co jen vypadá věrohodně. OpenAI tomu říká halucinace a samo vysvětluje, že trénink i hodnocení modelů často odměňují tipování víc než přiznání „nevím“ (OpenAI 2025). Není to tedy náhodná chyba, je to vlastnost toho, jak modely fungují.
Dva příklady ze zdravotnictví:
- Když ChatGPT (verze 3.5) psal krátké odborné texty o medicíně, ze 115 citovaných zdrojů bylo 47 % úplně vymyšlených a 46 % skutečných, ale s chybnými údaji. Správně bylo jen 7 % (Bhattacharyya 2023). Novější modely jsou lepší, ale chyby dělají dál.
- V randomizované studii z Oxfordu řešilo 1 298 lidí deset modelových zdravotních situací. Samotné modely správně určily onemocnění v 94,9 % případů. Lidé, kteří s nimi mluvili, ale jen v méně než 34,5 % případů, tedy ne lépe než kontrolní skupina, která hledala po svém (Bean 2026). Lidé často nevěděli, jaké informace model potřebuje, a v odpovědích se jim mísily dobré a špatné rady (University of Oxford).
Proto je v době AI kritické myšlení a obecný rozhled důležitější než dřív. Musíš poznat, kdy si model vymýšlí.
AI je hlas, ne zdroj
Neptám se AI „z hlavy“. Ptám se jí na svoje data.
AI smí:
- číst moje výsledky a porovnávat je v čase,
- vysvětlit lidsky, co znamenají,
- přeložit dlouhou studii v cizím jazyce do srozumitelné řeči.
AI nesmí:
- brát čísla z paměti. Po dlouhé konverzaci se snadno stane, že z mých 6,9 udělá 9,2. Výzkum ukazuje, že modely v dlouhém textu hůř pracují s informacemi uprostřed, i když je mají k dispozici (Liu 2024).
- doplnit, co chybí. Když něco v datech není, má to říct.
Čísla patří do dat, ne do „hlavy“ modelu.
Víc dat, lepší odpovědi
Jeden výsledek je jeden bod. Mezi body AI jen hádá. Ukážu to na cholesterolu (čísla jsou ukázková):
- Přijdu k lékaři: „Mám celkový cholesterol 6,9.“ Jediné číslo nad doporučenou hodnotou vede k debatě, jak ho snížit.
- Přijdu jinak: „Mám 6,9. Loni 7,9, předtím 8,9 a před třemi lety 10. Změnil jsem životní styl.“ Najednou je vidět, že to, co dělám, funguje, a rozhovor je úplně jiný.
Stejné číslo, jiný závěr. Čím víc zdrojů, tím víc souvislostí. Tolik souvislostí člověk sám těžko pobere a tady AI pomůže připravit podklady. Rozhoduje ale lékař.
Triangulace: genom, krev, spánek
Data mám rozdělená do tří vrstev. Každá odpovídá na jinou otázku:
- Genom je základ. Ukazuje predispozice, k čemu mám sklony v dobrém i zlém. Za život se prakticky nemění.
- Krev je otisk v čase. Patří sem i složení těla. Dává mi cíl do dalšího měření, na půl roku nebo na rok.
- Spánek je dnešní den. Regeneraci a připravenost měří prsteny, hodinky a náramky.
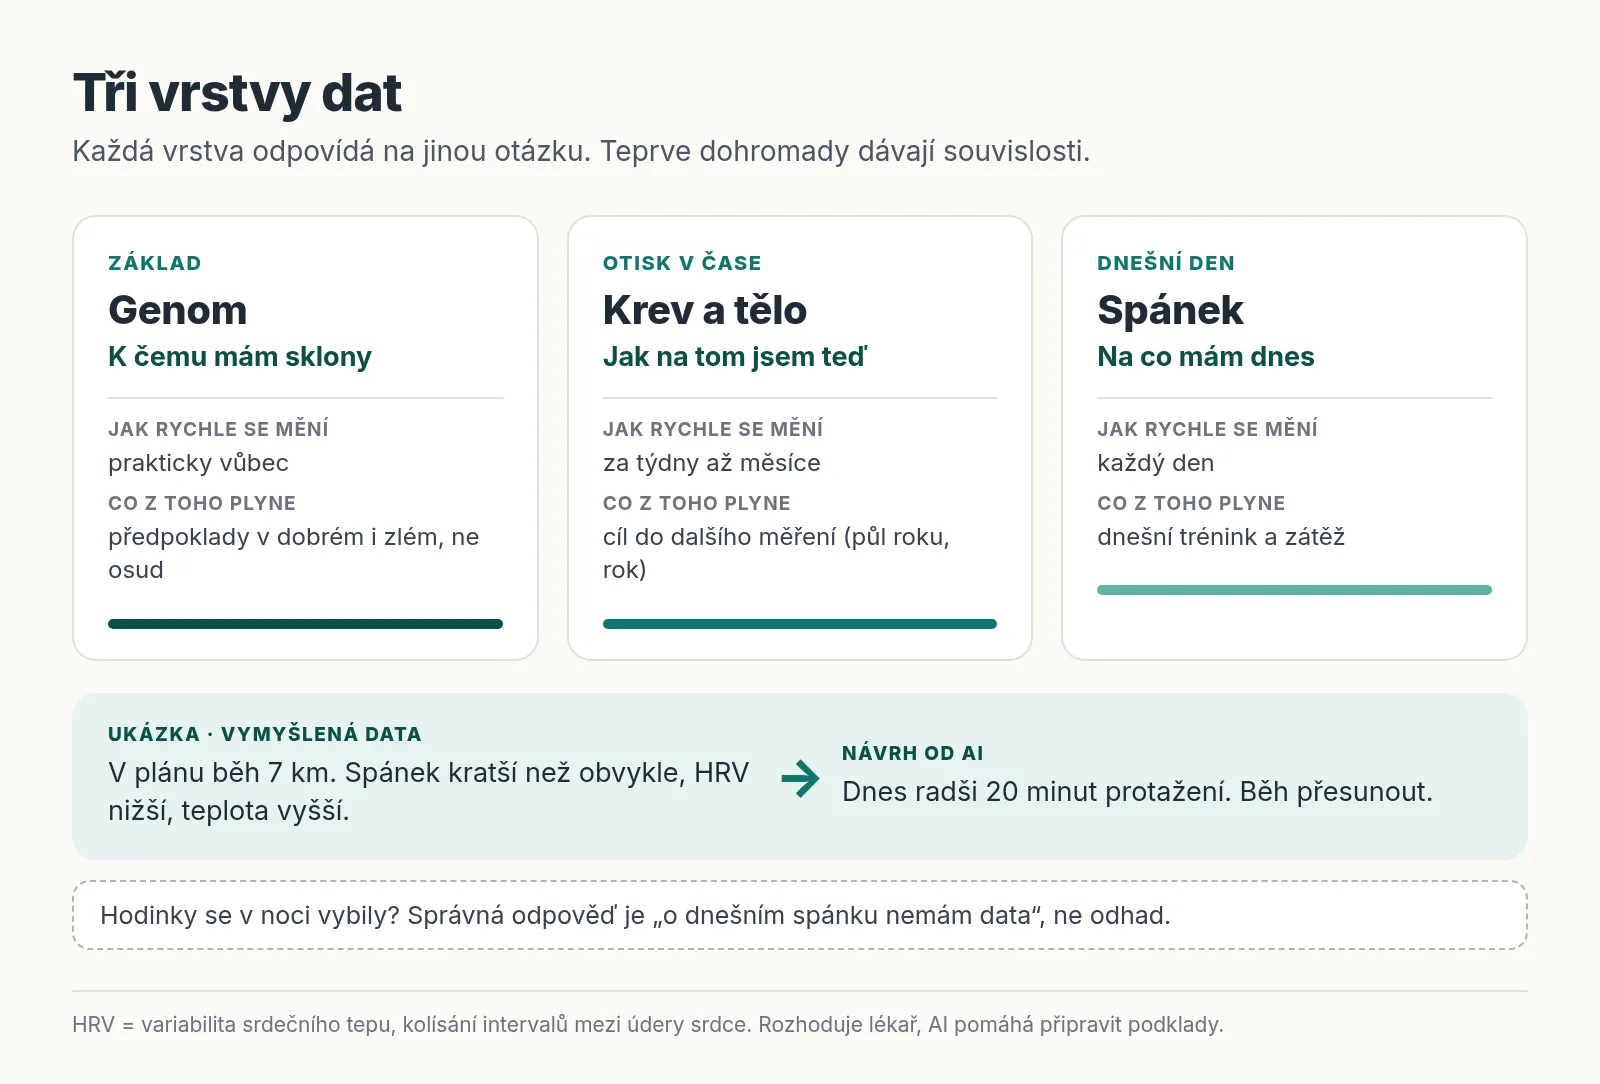
Příklad: na dnešek mám v plánu běh 7 km. Hodinky ale ukazují kratší spánek, vyšší teplotu a nižší HRV (variabilitu srdečního tepu, tedy jak moc kolísají intervaly mezi údery srdce, Shaffer a Ginsberg 2017). Rozumná rada zní: dej si dnes radši 20 minut protažení. Funguje to i obráceně. Cítím se líně, ale čísla jsou dobrá, tak jdu trénovat.
Data z nositelné elektroniky ale neber jako laboratoř. Ve srovnání se spánkovou laboratoří (polysomnografií) poznala většina testovaných zařízení spánek dobře, bdění v noci hůř a fáze spánku nespolehlivě. Při narušeném spánku byla přesnost horší (Chinoy 2021). Pro trend to stačí, na jednu noc bych nesázel.
Tým odborníků, který by mi každý den vyhodnocoval genom, krev, spánek a trénink dohromady, doma nemám. AI je hlas nad těmi daty.
Koučink, ne diagnóza
Modelu dávám tři pravidla:
- Čísla jen z dat, nikdy z paměti chatu.
- Prázdno místo odhadu. Když se hodinky v noci vybily, správná odpověď je „o dnešním spánku nemám data“, ne „spal jsi výborně“.
- Koučink, ne diagnóza. Diagnóza a léčba patří k lékaři.
Samotná věta „nevymýšlej si“ v zadání nestačí. Čísla v odpovědi proto vždy kontroluju proti zdroji.
Nebýt nemocný neznamená být zdravý
Každý krevní ukazatel má na výsledcích referenční rozmezí. To ale není hranice mezi zdravím a nemocí. Laboratoř ho obvykle počítá tak, že do něj spadá 95 % zdravých lidí z referenční skupiny. Zbylých 5 % zdravých lidí je tedy „mimo normu“ (Ozarda 2016).
Vymyšlený příklad: rozmezí je 10 až 100. S hodnotou 11 slyším „všechno v pořádku“, s 9 „máte problém“. Přitom z 11 na 9 je kousek. A teď si představ, že optimum by bylo třeba 60 až 70. Mezi 11 a 60 je obrovský rozdíl, a přesto obě hodnoty projdou jako „v normě“. U některých ukazatelů navíc existují cílové hodnoty z velkých studií, které se od referenčního rozmezí liší. Typický je cholesterol (Ozarda 2016). Tady mi AI pomáhá hledat, kam se posunout, pokud chci být zdravý, ne jen nebýt nemocný.
Pozor ale na „optimální rozmezí“ z internetu. Spousta jich nemá oporu ve studiích. Když mi AI nějaké optimum navrhne, chci k němu zdroj. A když je hodnota mimo referenční rozmezí, svítí červená kontrolka a jdu k lékaři.
Jak to dělám: od chatu k vlastnímu systému
Moje cesta měla pět kroků:
- Chat. Začínal jsem jako většina lidí: všechno jsem nasypal do chatu. Fungovalo to, ale v dlouhé konverzaci model zapomínal a vymýšlel si. Musel jsem pořád hlídat a zakládat nová vlákna.
- Gemini a notebook. Pak jsem přešel na notebook nad vlastními PDF (tehdy NotebookLM, dnes Gemini Notebook), napojený do Gemini. To byl velký skok, odpovědi stály na mých datech a šly ověřit.
- Vlastní systém s modelem v cloudu. Začal jsem si vlastní systém vibecodovat, tedy stavět software tak, že AI popisuju, co má dělat, a kód píše ona. Model jsem volal přes API, programové rozhraní, kterým aplikace posílá dotazy rovnou na model poskytovatele. Proti chatu to bylo lepší v soukromí: velcí poskytovatelé data z placeného API ve výchozím stavu nepoužívají k trénování a uchovávají je jen omezenou dobu kvůli kontrole zneužití, u OpenAI a Anthropicu do 30 dnů, u Gemini 55 dnů (OpenAI, Google, Anthropic). Data ale pořád odcházela z mého počítače.
- Vlastní systém s lokálním modelem. Chtěl jsem nad svými daty používat lokální modely a mít absolutní kontrolu nejen nad tím, jak se data zpracovávají, ale i nad tím, co celý systém umí. Model teď běží u mě a data nikam neposílám.
- Produkt. Z domácího systému vyrostl komerční produkt. Tady otevřeně: jde o moji firmu. S kamarádem vyvíjíme Methos BiOS a podrobně o něm napíšu v samostatném článku.
Vlastní systém ale není pro každého. Pro většinu lidí je rozumná střední cesta notebook, a ten tady popíšu.
Notebook nad vlastními zdroji
Notebook je nástroj, který odpovídá jen z nahraných souborů a cituje je. Příkladem je Gemini Notebook, do července 2026 NotebookLM (Google). Jde ho napojit i do aplikace Gemini. Tam se pak chaty řídí podle nastavení Uchovávat aktivitu, včetně kontroly lidmi (Gemini Apps Privacy Hub).
Krok 0 (stačí jednou): odstraň osobní údaje. Jméno, rodné číslo a adresu AI k ničemu nepotřebuje, stačí věk. Pozor na jednu past: černý obdélník nakreslený v prohlížeči PDF text většinou neodstraní, jen ho zakryje. Pod ním zůstane a jde zkopírovat, a AI čte právě text. Použij funkci pro začernění (redakci), která text opravdu smaže, a pak zkus text v daném místě označit a zkopírovat (Macworld).
Pak: nový notebook → přidat zdroje → nahrát upravená PDF.
Notebook funguje jako datový trezor. Odpovídá jen z nahraných zdrojů a u odpovědí ukazuje citace. Po kliknutí na citaci se otevře přesné místo ve zdroji (Gemini Notebook Help). Halucinuje tak mnohem méně a hlavně se to dá ověřit. Nulové riziko to ale není.
Podle Googlu se na nahraných datech netrénuje, pokud k odpovědi nedáš zpětnou vazbu (👍/👎). Když ji dáš, může Google projít celou interakci včetně nahraných souborů. Zdarma můžeš mít v jednom notebooku 50 zdrojů, v placeném plánu Pro 300 (Gemini Notebook Help). Na zdravotní výsledky to bohatě stačí. Mimochodem, stejně dobře to funguje i na učení.
Prompt níže nemusíš vkládat do každého chatu. Nejjednodušší je uložit ho jako vlastní instrukce notebooku: v chatu klikni na Konfigurace chatu → Vlastní. Platí pak v Gemini Notebooku i v Gemini (Gemini Notebook Help). V Gemini si z promptu můžeš udělat i asistenta. Dřív se tomu říkalo robot Gem, u osobních účtů je od 17. listopadu 2026 nahradily dovednosti (Gemini Apps Help). Postup: Přizpůsobit → Dovednosti → vytvořit, prompt vložit do instrukcí a přes Přidat → Sešity připojit notebook. Dovednost pak zavoláš v libovolném chatu jejím názvem. Je jen pro lidi od 18 let (Gemini Apps Help). V Gemini ale odpovědi můžou kromě tvých zdrojů čerpat i z webu (Gemini Notebook Help), proto je v promptu hned první věta „odpovídej jen z mých zdrojů“.
Zobrazit prompt pro AI
Odpovídej jen z mých zdrojů v tomto notebooku. Když to v nich není, napiš „v mých datech to není“ a nic nedoplňuj.
U každého čísla uveď, ze kterého zdroje a z jakého data je.
Čísla nikdy neber z paměti ani z předchozí konverzace, vždy je znovu najdi ve zdrojích.
Když data chybí (například záznam spánku za poslední noc), řekni to a nehádej.
Jsi kouč, ne lékař. Nestanovuj diagnózu ani léčbu. Když je hodnota mimo referenční rozmezí laboratoře, napiš, že to patří k lékaři.
Na konci vypiš, co bych měl ověřit a na co se zeptat lékaře.
Klikni aspoň na tu citaci. Odkaz nemusí fungovat, nebo vede úplně jinam. U běžného chatu se klidně stane, že se po kontrole omluví: „Máš pravdu, tohle je studie o počůrávání u malých dětí a ty ses ptal na cholesterol.“
Co se může stát s tím, co vložíš
Už se stalo
- Sdílené chaty ve vyhledávači. V roce 2025 našel Google zhruba 4 500 sdílených chatů z ChatGPT. Šlo o chaty, u kterých lidé při sdílení zaškrtli, že je smějí najít vyhledávače. OpenAI pak tuto volbu zrušilo (Fast Company, Fast Company). U Groku bylo ve vyhledávání přes 370 000 konverzací, protože tlačítko pro sdílení vytvářelo veřejné stránky bez upozornění (Forbes). Mezi nimi byly i dotazy na zdraví. Sdílený odkaz otevře kdokoli, kdo ho má. Když chceš něco ukázat kamarádovi, zkopíruj text a pošli ho zprávou nebo e-mailem.
- Chyba v kódu. V březnu 2023 viděli někteří uživatelé ChatGPT názvy cizích konverzací a u malé části předplatitelů mohly být vidět i částečné platební údaje. Příčinou byla chyba v open-source knihovně, ne hacker (OpenAI).
- Ukradená přihlášení. Firma Group-IB našla na černém trhu přihlašovací údaje k ChatGPT ze 101 134 zařízení. Neuhodl je nikdo. Ukradl je škodlivý program z nakažených počítačů, který vysbírá hesla uložená v prohlížeči (Group-IB). Ukradený účet znamená přístup ke všem tvým chatům.
Může se stát
- Data změní majitele. Firma 23andMe, která dělala genetické testy, v roce 2025 zbankrotovala. Její služby i s daty zákazníků koupila nezisková organizace TTAM Research Institute za 305 milionů dolarů (23andMe, SEC). Obchodní podmínky skoro nikdo nečte. Nech si je aspoň shrnout od AI a zeptej se, co se stane s daty při prodeji firmy.
- Prompt injection. Do dokumentu nebo webové stránky jde schovat text, třeba bílým písmem na bílém pozadí, který AI „přikáže“ něco udělat, například vynést data. Člověk ho nevidí, model ho přečte (OWASP). Nenahrávej do AI soubory z neznámých zdrojů spolu s citlivými daty.
- Zneužití u pojišťovny nebo zaměstnavatele. Údaje o zdraví a genetická data mají v EU zvláštní ochranu (GDPR, čl. 9) a diskriminace kvůli genetické výbavě je zakázaná i úmluvou o biomedicíně, kterou Česko ratifikovalo (Úmluva z Ovieda, čl. 11). Zákon ale nepomůže, když data jednou uniknou.
Nejsou to jen tvoje data
Zpráva od lékaře za rodiče, recept kamaráda, genom. Genom prozradí něco i o příbuzných. U 23andMe se útočníci v roce 2023 dostali do zhruba 14 000 účtů pomocí hesel uniklých jinde a přes funkce pro hledání příbuzných pak k údajům zhruba 6,9 milionu lidí (23andMe). Podle studie v Science by stačila databáze s 1,3 milionu lidí, aby asi 60 % Američanů evropského původu v ní mělo příbuzného na úrovni vzdáleného bratrance (třetího stupně) nebo bližšího (Erlich 2018).
Zpráva od lékaře, kterou ti dala máma, není souhlas se zpracováním jejích údajů. A i bez jména může detail prozradit, o koho jde: „Pepa Vzorový z naší ulice má nízký testosteron.“
Kam s citlivými daty
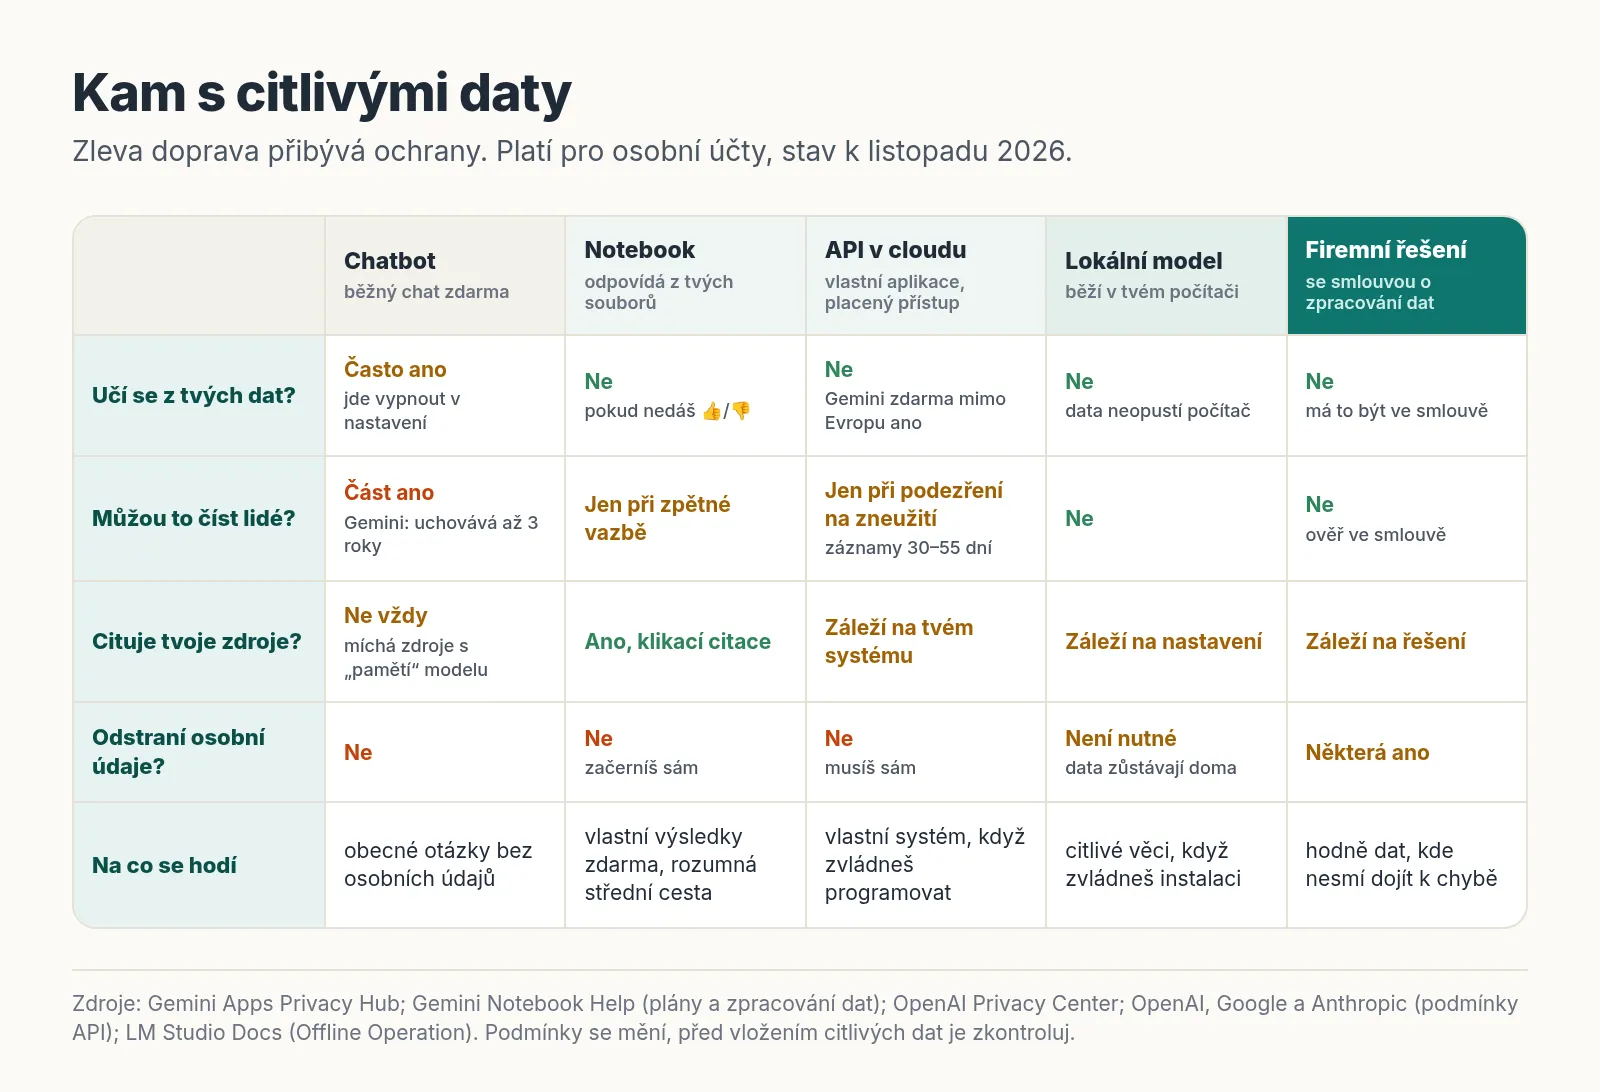
- Obecné otázky („co je HRV“) klidně do běžného chatu, ale bez osobních údajů. U Gemini část chatů čtou lidé a takové chaty se uchovávají až 3 roky, i když je smažeš (Gemini Apps Privacy Hub).
- Vlastní výsledky zdarma: notebook nad vlastními zdroji. Zlatá střední cesta.
- Vlastní aplikace přes API: když umíš programovat (nebo vibecodovat), placené API velkých poskytovatelů se ve výchozím stavu na datech netrénuje. Pozor na bezplatnou verzi Gemini API: mimo Evropu Google data z ní používá k vylepšování modelů a mohou je číst lidé. V EU, Švýcarsku a Spojeném království pro ni platí stejná pravidla jako pro placenou (Google). Data ale pořád odcházejí z počítače a API klíč chraň jako heslo: nepatří do kódu ani do sdílených souborů a nastav si limit útraty (OpenAI).
- Citlivé věci úplně doma: lokální model v počítači, například přes LM Studio nebo Ollama. Po stažení modelu běží bez internetu a to, co do něj vložíš, neopustí počítač (LM Studio). Vyžaduje to ale výkonnější počítač a trochu nastavování.
- Hodně dat a žádné chyby: profesionální řešení se smlouvou o zpracování dat (DPA, smlouva, ve které se poskytovatel zavazuje, co s daty smí a nesmí dělat). U OpenAI se ve výchozím stavu netrénuje na datech z firemních tarifů Business a Enterprise (OpenAI). U takového řešení si ověř, že se na datech netrénuje, že je nečtou lidé, že umí odstranit osobní údaje a že vede auditní log, tedy záznam o každém přístupu k datům.
Sem vedla i moje cesta, k řešení Methos BiOS, které vyvíjím s kamarádem. Je to moje firma, takže ho tu nehodnotím.
Jak riziko zmenšit
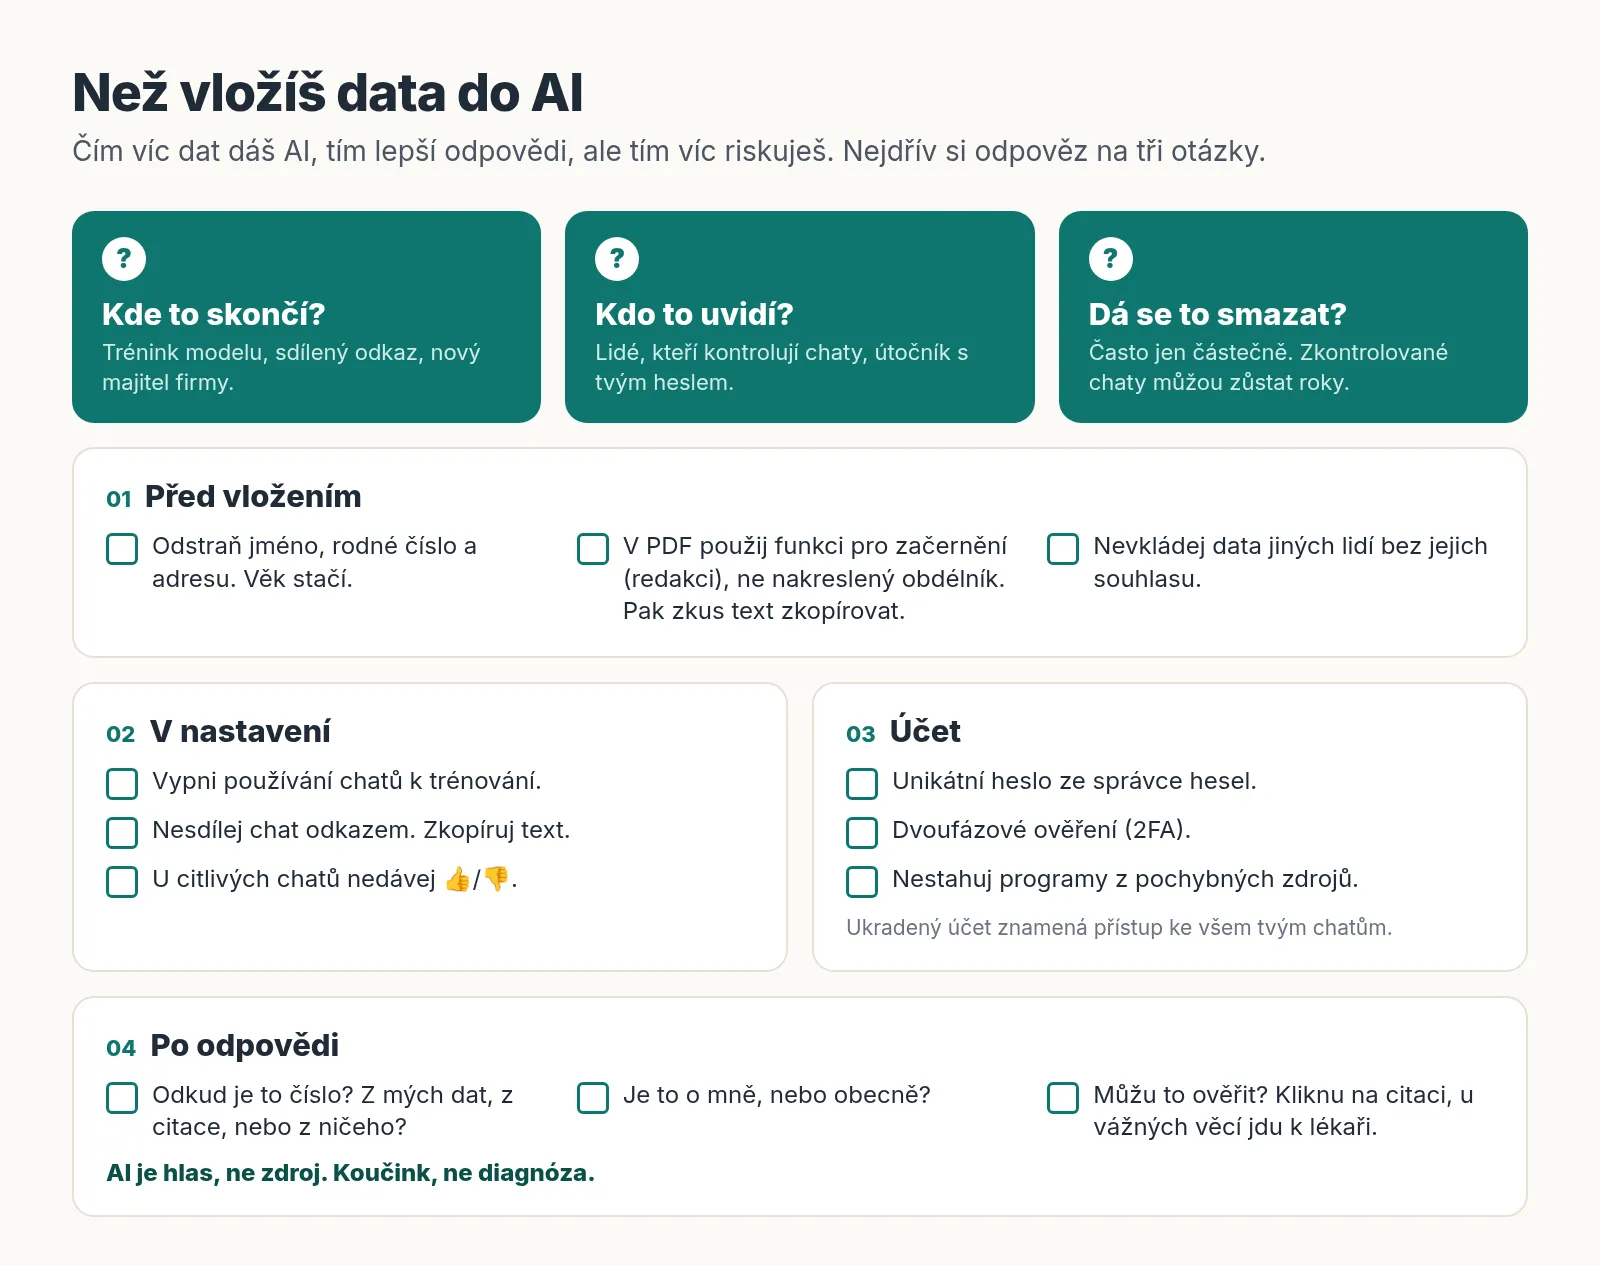
1. Před vložením. Odstraň jméno, rodné číslo a adresu skutečným začerněním. Citlivé věci dávej jen do notebooku, do vlastního systému přes placené API, nebo nejlépe do lokálního modelu.
2. V nastavení. V nastavení soukromí nebo dat vypni používání chatů k trénování modelu. Nesdílej chaty odkazem, zkopíruj text. U citlivých chatů nedávej 👍/👎, zpětnou vazbu můžou služby použít i při vypnutém trénování. Názvy voleb se mění a každá služba je má jinde. Když volbu nenajdeš, zeptej se přímo dané AI, kde ji vypneš.
3. Účet. Silné unikátní heslo, ideálně ze správce hesel, a dvoufázové ověření (2FA): po zadání hesla ještě potvrdíš přihlášení kódem nebo v telefonu. Útok na 23andMe stál právě na heslech, která lidé používali i jinde (23andMe). A nestahuj programy z pochybných zdrojů, krádeže přihlášení k ChatGPT šly přes nakažené počítače (Group-IB). „Pepa123“ není heslo.
Tři otázky na každou radu od AI
- Odkud je to číslo? Z mých dat, z citace, nebo z ničeho?
- Je to o mně, nebo obecně? Nezajímá mě, že 99 lidí ze 100 je v pohodě. Chci odpověď nad svými daty, a když nejsou, ať to AI řekne.
- Můžu to ověřit? Kliknu na citaci. U vážných věcí jdu k lékaři.
Když rada neobstojí ani u jedné otázky, čtu ji jako horoskop.
Zdroje
- OpenAI (2025): Why language models hallucinate
- Bhattacharyya M a kol. (2023): High Rates of Fabricated and Inaccurate References in ChatGPT-Generated Medical Content. Cureus.
- Bean AM a kol. (2026): Reliability of LLMs as medical assistants for the general public: a randomized preregistered study. Nature Medicine.
- University of Oxford (2026): New study warns of risks in AI chatbots giving medical advice
- Liu NF a kol. (2024): Lost in the Middle: How Language Models Use Long Contexts. TACL.
- Shaffer F, Ginsberg JP (2017): An Overview of Heart Rate Variability Metrics and Norms. Front Public Health.
- Chinoy ED a kol. (2021): Performance of seven consumer sleep-tracking devices compared with polysomnography. Sleep.
- Ozarda Y (2016): Reference intervals: current status, recent developments and future considerations. Biochem Med.
- Google (2026): NotebookLM is now Gemini Notebook
- Gemini Notebook Help: Use chat in Gemini Notebook
- Gemini Notebook Help: Learn about Gemini Notebook’s plans
- Google: Gemini Apps Privacy Hub
- Macworld (2024): How to easily redact text in a PDF on your Mac
- Fast Company (2025): Google is indexing ChatGPT conversations a OpenAI pulls ChatGPT feature that showed personal chats on Google
- Forbes (2025): xAI published hundreds of thousands of Grok chatbot conversations
- OpenAI (2023): March 20 ChatGPT outage: Here’s what happened
- Group-IB (2023): 100K+ compromised ChatGPT accounts on dark web marketplaces
- 23andMe (2023): Addressing Data Security Concerns
- TTAM Research Institute (2025): Completes the acquisition of 23andMe assets a SEC Form 8-K
- OWASP (2025): LLM01:2025 Prompt Injection
- Nařízení (EU) 2016/679, GDPR, čl. 9
- Rada Evropy: Úmluva o lidských právech a biomedicíně, čl. 11
- Erlich Y a kol. (2018): Identity inference of genomic data using long-range familial searches. Science.
- LM Studio Docs: Offline Operation
- OpenAI Help Center: Privacy Center in ChatGPT
- OpenAI: Data controls in the OpenAI platform
- Google: Gemini API Additional Terms of Service a Abuse monitoring
- Anthropic Privacy Center: How long do you store my organization’s data?
- OpenAI Help Center: Best practices for API key safety
- Gemini Notebook Help: Notebooks in Gemini Apps
- Gemini Apps Help: About the transition from Gems to skills
- Gemini Apps Help: Create & manage skills for Gemini Apps